https://product.kyobobook.co.kr/detail/S000001952215
시계열 데이터 처리와 분석 in R - 교보문고
복잡한 수학 공식 없이 코드 위주의 설명과 실제 데이터를 통해 배우는 시계열 데이터와 알고리즘! 20여 년간 우리나라의 교육통계 데이터를 다뤄온 저자가 꼼꼼하게 안내하는 시계열 데이터 입
product.kyobobook.co.kr
소개
지난 글에서는 주식 수익률을 예측하기 위한 선형 회귀 모델을 만들었다. 이 과정에서 한 가지 중요한 사실을 확인했다. 단순한 모델은 종종 과소적합(underfitting) 되어 신호를 제대로 포착하지 못하는 반면, 고차 다항식과 같은 복잡한 모델은 과적합(overfitting) 되어 데이터의 노이즈까지 학습해 버린다.
금융 데이터는 본질적으로 '신호 대 노이즈(signal-to-noise)' 비율이 매우 낮다. 따라서 견고한 트레이딩 전략을 만들려면 의미 있는 패턴을 학습할 만큼 충분히 복잡하면서도, 시장의 무작위 변동은 무시할 수 있도록 적절히 제약된 모델이 필요하다.
이 튜토리얼에서는 모델의 과적합을 방지하기 위해 학습 과정에 수학적인 '브레이크'를 거는 방법인 정규화(Regularization)를 소개한다. 그리고 Ridge, Lasso, ElasticNet 회귀를 사용해 기존 모멘텀 전략을 개선해 본다.
학습 목표
이 튜토리얼을 마치면 다음 내용을 이해하고 활용할 수 있다.
- Ridge(L2), Lasso(L1), ElasticNet 정규화의 수학적 차이를 설명할 수 있다.
- scikit-learn을 사용해 이러한 기법을 적용하고 표본 외(out-of-sample) 성능을 개선할 수 있다.
- 시계열을 고려한 검증 방법인 TimeSeriesSplit과 Grid Search를 사용해 하이퍼파라미터 튜닝(Hyperparameter Tuning)을 수행할 수 있다.
- Lasso 회귀가 불필요한 신호의 계수를 0으로 만들어 자동으로 변수를 선택하는 과정을 시각화할 수 있다.
사전 준비
- Part 1 완료: 이전 글에서 사용한 데이터셋과 피처 엔지니어링 로직이 필요하다.
- 라이브러리: scikit-learn, pandas, numpy, matplotlib, yfinance
비용 함수와 페널티
일반적인 선형 회귀(Ordinary Least Squares — OLS)에서는 평균제곱오차(Mean Squared Error, MSE)를 최소화하도록 모델을 학습한다.
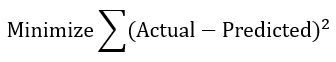
정규화(Regularization)는 이 식에 페널티 항(Penalty Term)을 추가한다. 이제 모델은 오차뿐만 아니라 계수(weights)의 크기도 함께 최소화해야 한다.
Ridge 회귀(L2 Norm)
Ridge는 계수를 제곱한 값에 해당하는 페널티를 추가한다.
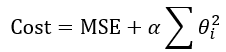
- 효과: 모든 계수를 0에 가까워지도록 축소하지만, 정확히 0이 되는 경우는 드물다.
- 사용 사례: 모든 피처가 조금씩 영향을 미치는 경우에 적합하다. 예를 들어 서로 상관관계가 있는 여러 기술적 지표를 사용하는 경우이다.
- 하이퍼파라미터($alpha$): 정규화의 강도를 조절한다. $alpha=0$이면 일반적인 OLS와 같다. $alpha$가 매우 커지면 모델은 평평한 직선에 가까워진다.
Lasso 회귀(L1 Norm)
Lasso는 계수의 절댓값에 해당하는 페널티를 추가한다.
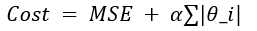
- 효과: 계수를 정확히 0으로 만들 수 있다.
- 사용 사례: **피처 선택(Feature Selection)**에 활용할 수 있다. 100개의 지표가 있지만 실제로 중요한 지표가 3개뿐이라면, Lasso는 나머지 97개 지표의 가중치를 0으로 만들어 자동으로 제거한다.
L1과 L2 페널티를 결합한 하이브리드 방식도 있다. 일반적으로 금융 시계열에서는 가장 안전한 선택으로 볼 수 있다.
실습
Step 1: 데이터 준비(복습)
Part 1에서 사용한 데이터셋을 빠르게 다시 만들어 본다. 다만 이번에는 더 많은 피처를 생성한다. 시차(lag)를 1부터 10까지 만들어 과적합 위험을 높이고, 정규화가 더 필요한 상황을 만든다.
import numpy as np
import pandas as pd
import yfinance as yf
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split, TimeSeriesSplit, GridSearchCV
from sklearn.linear_model import Ridge, Lasso, ElasticNet
from sklearn.metrics import mean_squared_error

# 1. 데이터 가져오기
df = yf.download('SPY', start='2010-01-01', end='2026-01-01')
df['Return'] = df['Close'].pct_change()
df.dropna(inplace=True)

# 2. 더 많은 피처 생성(Lag 1~10)
# 피처가 많을수록 과적합 위험이 커짐 = 정규화를 테스트하기에 더 적합함
lags = 10
feature_cols = []
for i in range(1, lags + 1):
    col_name = f'Lag_{i}'
    df[col_name] = df['Return'].shift(i)
    feature_cols.append(col_name)

df.dropna(inplace=True)

X = df[feature_cols]
y = df['Return']

# 3. 데이터 분할(시간 순서 유지)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, shuffle=False)

print(f"Training Features: {X_train.shape[1]} inputs (Lags 1-10)")
Step 2: Ridge 회귀(수동 튜닝)
임의의 alpha 값을 사용해 Ridge 회귀가 어떻게 작동하는지 확인해 본다.
# 특정 alpha 값으로 Ridge 초기화(정규화 강도)
# Alpha = 1.0은 일반적으로 사용할 수 있는 시작점임
ridge_model = Ridge(alpha=1.0)
ridge_model.fit(X_train, y_train)

# 예측
y_pred_ridge = ridge_model.predict(X_test)
mse_ridge = mean_squared_error(y_test, y_pred_ridge)

print(f"Ridge MSE (alpha=1.0): {mse_ridge:.8f}")
print("Ridge Coefficients:", ridge_model.coef_)
Step 3: Lasso 회귀(피처 선택)
이번에는 Lasso를 살펴본다. 몇 개의 계수가 정확히 0.0이 되는지 주의해서 확인한다.
# Lasso 초기화
# 수익률 자체가 작은 값이므로 작은 alpha를 사용한다고 가정함
lasso_model = Lasso(alpha=0.0001)
lasso_model.fit(X_train, y_train)

# 계수 확인
print("\nLasso Coefficients:")
for feature, coef in zip(feature_cols, lasso_model.coef_):
    print(f"{feature}: {coef:.6f}")

# 0이 아닌 피처 개수 확인
n_selected = np.sum(lasso_model.coef_ != 0)
print(f"\nLasso selected {n_selected} out of {lags} features.")
참고: Lasso가 모든 계수를 0으로 만든다면 alpha 값이 너무 큰 것이다. 반대로 모든 계수를 그대로 유지한다면 alpha 값이 너무 작은 것이다.
Step 4: Grid Search를 이용한 하이퍼파라미터 튜닝
alpha 값을 직접 추측하는 것은 비효율적이다. GridSearchCV를 사용하면 여러 값을 자동으로 테스트할 수 있다.
특히 금융 데이터에서는 미래 정보를 미리 사용하는 문제인 룩어헤드 바이어스(look-ahead bias)를 방지하기 위해 무작위 K-Fold 검증 대신 TimeSeriesSplit을 사용한다.
# TimeSeriesSplit 정의(시간 순서를 고려한 교차검증)
# 학습 데이터가 점점 확장되는 형태로 분할됨
tscv = TimeSeriesSplit(n_splits=5)

# 모델 정의
elastic = ElasticNet()

# 테스트할 파라미터 범위 정의
# alpha: 정규화 강도
# l1_ratio: Lasso(1.0)와 Ridge(0.0)의 혼합 비율
param_grid = {
    'alpha': [0.00001, 0.0001, 0.001, 0.01, 0.1, 1.0],
    'l1_ratio': [0.1, 0.5, 0.9]
}

# Grid Search 설정
grid_search = GridSearchCV(
    estimator=elastic,
    param_grid=param_grid,
    cv=tscv,
    scoring='neg_mean_squared_error',
    verbose=1
)

# 학습 데이터에 적합
# GridSearch가 내부 검증 분할을 처리함
grid_search.fit(X_train, y_train)

print(f"Best Parameters: {grid_search.best_params_}")
print(f"Best Internal Score (Negative MSE): {grid_search.best_score_}")
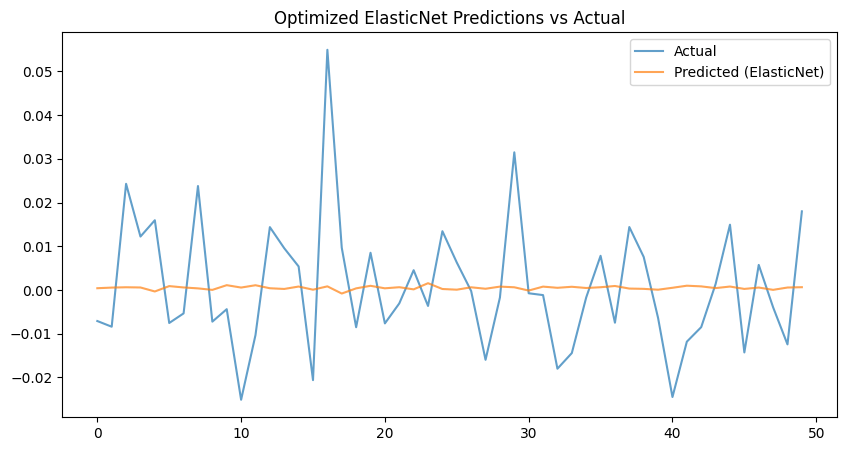
Step 5: 최종 평가
Grid Search에서 찾은 "최적" 모델을 가져와 별도로 남겨둔 테스트 데이터셋에서 평가한다.
# 최적 모델 가져오기
best_model = grid_search.best_estimator_

# 테스트 데이터 예측
y_pred_best = best_model.predict(X_test)
final_mse = mean_squared_error(y_test, y_pred_best)

print(f"Final Optimized ElasticNet MSE: {final_mse:.8f}")

# 시각화 확인
plt.figure(figsize=(10, 5))
plt.plot(y_test.values[:50], label='Actual', alpha=0.7)
plt.plot(y_pred_best[:50], label='Predicted (ElasticNet)', alpha=0.7)
plt.legend()
plt.title("Optimized ElasticNet Predictions vs Actual")
plt.show()
결과 확인
- Lasso의 0 계수: Step 3에서 Lasso가 최소 하나 이상의 계수를 정확히 0.0 또는 0에 매우 가까운 값으로 만들었는지 확인한다.
- Grid Search 출력: GridSearchCV가 "Best Parameters"를 출력했는지 확인한다.
- 계수 크기: Part 1에서 사용한 OLS 모델의 계수와 새로 생성한 Ridge/ElasticNet 계수를 비교한다. 정규화된 모델의 계수는 더 작고 0에 가까워야 한다.
도전 과제: Alpha 곡선
1e-6부터 1e-2까지의 alpha 값을 사용해 Lasso를 테스트하는 반복문을 작성한다. 각 alpha 값에 대해 0이 아닌 계수의 개수를 저장한다. 그런 다음 Alpha(x축)와 선택된 피처의 개수(y축)를 그래프로 그린다. 이를 통해 정규화 강도가 증가할수록 피처가 얼마나 적극적으로 제거되는지 시각적으로 확인할 수 있다.
결론 및 다음 단계
모델을 성공적으로 '길들였다'. 정규화(Regularization)를 사용함으로써 노이즈에 과적합될 위험을 줄였다. 또한 TimeSeriesSplit을 이용한 Grid Search를 구현해 금융 모델의 하이퍼파라미터를 튜닝하는 전문적인 워크플로를 구축했다.
하지만 여전히 연속적인 숫자인 수익률(Return)을 예측하고 있다. 트레이딩에서는 정확한 수익률의 크기보다 시장의 방향, 즉 상승(Up) 또는 하락(Down) 여부가 더 중요한 경우가 많다.
다음 단계: Part 3에서는 회귀(Regression)에서 분류(Classification)로 전환한다. 로지스틱 회귀(Logistic Regression)를 사용해 시장이 상승할 확률을 예측하고, 정확도(accuracy), 정밀도(precision), 혼동 행렬(Confusion Matrix)을 사용해 모델의 성능을 평가하는 방법을 살펴본다.
문제 해결 / FAQ
Q: Grid Search에서 가장 작은 alpha 값이 최적의 값으로 나왔다. 왜 그런가?
A: 이는 모델이 과소적합 상태이며 더 약한 정규화를 원한다는 의미이다. Grid에 더 작은 값(예: 1e-6, 1e-7)을 추가하거나, 다항식 피처(polynomial features)와 같이 더 복잡한 피처를 추가해 정규화의 필요성을 높여볼 수 있다.
Q: 왜 neg_mean_squared_error를 사용하는가?
A: scikit-learn의 최적화 과정은 항상 점수를 최대화하는 방향으로 동작한다. MSE는 오차이므로 최소화해야 한다. 따라서 sklearn은 MSE에 음수 부호를 붙여 "음수 오차를 최대화"하는 것이 수학적으로 "오차를 최소화"하는 것과 같도록 만든다.
Q: TimeSeriesSplit 대신 KFold를 사용할 수 있는가?
A: 일반적인 머신러닝에서는 가능하다. 하지만 금융에서는 사용하면 안 된다. KFold는 데이터를 섞기 때문에 2021년 데이터로 학습한 모델을 2020년 데이터로 검증하는 상황이 발생할 수 있다. 이는 시간의 인과관계를 무너뜨리고 비현실적인 성능 추정으로 이어진다.
<출처: https://simplified-zone.com/machine-learning-for-quants-part-2/>
'금융 데이터 분석' 카테고리의 다른 글
| Python으로 배우는 ‘퀀트를 위한 머신러닝’ 시리즈 - Part 4: 실제 사례 연구 – 신용 부도 예측 (0) | 2026.09.16 |
|---|---|
| Python으로 배우는 ‘퀀트를 위한 머신러닝’ 시리즈 - Part 3: 로지스틱 회귀와 분류를 활용한 시장 방향 예측 (0) | 2026.09.15 |
| 주식 시장을 통해 이해하는 베이즈 정리 (0) | 2026.06.14 |
| 금융 분석과 주식 시장 예측을 위한 Python (0) | 2026.06.13 |
| 금융 데이터 분석을 위한 분위수 회귀(Quantile Regression) 소개 (0) | 2026.06.13 |


댓글