https://product.kyobobook.co.kr/detail/S000001952215
시계열 데이터 처리와 분석 in R - 교보문고
복잡한 수학 공식 없이 코드 위주의 설명과 실제 데이터를 통해 배우는 시계열 데이터와 알고리즘! 20여 년간 우리나라의 교육통계 데이터를 다뤄온 저자가 꼼꼼하게 안내하는 시계열 데이터 입
product.kyobobook.co.kr
소개
머신러닝 튜토리얼을 조금이라도 따라 해본 적이 있다면 다음과 같은 코드를 분명 한 번쯤 작성해봤을 것이다.
from sklearn.preprocessing import MinMaxScaler, StandardScaler
그러고 나서 이런 의문이 들었을 것이다. 둘 중 어떤 것을 사용해야 하고, 그 이유는 무엇일까?
정규화(Normalisation)와 표준화(Standardisation)는 모두 모델링 전에 수치형 데이터의 스케일을 조정하는 특성 스케일링(feature scaling) 기법이다.
두 기법은 흔히 함께 언급되며, 초보자들은 종종 같은 의미로 혼용하기도 한다. 하지만 두 기법은 서로 다른 방식으로 데이터를 변환하며, 잘못 선택하면 모델의 성능에도 영향을 줄 수 있다.
이 글에서는 각 기법이 어떤 역할을 하는지, Python에서 어떻게 구현하는지, 그리고 각각 어떤 상황에서 사용해야 하는지 살펴본다.
정규화(Normalisation)란 무엇인가?
정규화는 모든 값이 일정한 범위 안에 들어오도록 데이터의 스케일을 조정하는 방법이다. 일반적으로 0에서 1 사이의 값으로 변환한다.

특성의 최솟값은 0, 최댓값은 1이 되며, 나머지 값들은 그 사이에서 비례적으로 조정된다.
Python 코드 예제
import numpy as np
import pandas as pd
from sklearn.preprocessing import MinMaxScaler

data = {
    'price': [150000, 250000, 400000, 500000, 1000000],
    'size_sqft': [800, 1200, 1800, 2200, 4000]
}
df = pd.DataFrame(data)

scaler = MinMaxScaler()
df_normalised = pd.DataFrame(
    scaler.fit_transform(df),
    columns=df.columns
)
출력 결과:
price: 150,000    [0.00]  |  size: 800 sqft    [0.00]
price: 250,000    [0.12]  |  size: 1,200 sqft  [0.13]
price: 400,000    [0.29]  |  size: 1,800 sqft  [0.31]
price: 500,000    [0.41]  |  size: 2,200 sqft  [0.44]
price: 1,000,000  [1.00]  |  size: 4,000 sqft  [1.00]
원래 사용하던 단위가 서로 달랐음에도 이제 두 특성 모두 동일하게 0~1 범위의 스케일을 갖게 된 것을 확인할 수 있다.
표준화(Standardisation)란 무엇인가?
표준화는 데이터의 평균이 0, 표준편차가 1이 되도록 스케일을 조정하는 방법이다. 정규화와 달리 값을 특정 범위 안으로 제한하지 않는다.
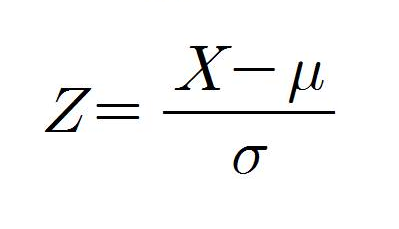
여기서 μ는 평균이고 σ는 표준편차이다.
표준화된 값(z-score)은 특정 데이터가 평균에서 표준편차 몇 배만큼 떨어져 있는지를 나타낸다. 예를 들어 2.0은 평균보다 표준편차의 2배만큼 높은 값이라는 의미이고, -1.5는 평균보다 표준편차의 1.5배만큼 낮은 값이라는 의미이다.
Python 코드 예제
import numpy as np
import pandas as pd
from sklearn.preprocessing import StandardScaler

data = {
    'price': [150000, 250000, 400000, 500000, 1000000],
    'size_sqft': [800, 1200, 1800, 2200, 4000]
}
df = pd.DataFrame(data)

scaler = StandardScaler()
df_standardised = pd.DataFrame(
    scaler.fit_transform(df),
    columns=df.columns
)
출력 결과:
price: 150,000    [-1.049]  |  size: 800 sqft    [-1.081]
price: 250,000    [-0.710]  |  size: 1,200 sqft  [-0.721]
price: 400,000    [-0.203]  |  size: 1,800 sqft  [-0.180]
price: 500,000    [0.135]   |  size: 2,200 sqft  [0.180]
price: 1,000,000  [1.827]   |  size: 4,000 sqft  [1.802]
각 기법은 언제 사용해야 하는가?
가장 중요한 질문이다. 하나씩 살펴보자.
정규화를 사용하는 경우
- 알고리즘이 일정한 범위의 값을 요구하는 경우
*Sigmoid나 tanh 활성화 함수를 사용하는 신경망은 입력값이 **0*에서 1 사이일 때 가장 잘 작동한다. 예를 들어 원래 0~255 범위인 이미지 픽셀 데이터는 거의 항상 0~1 범위로 정규화한다. - 데이터에 큰 이상치가 없다는 것을 알고 있는 경우
정규화는 최솟값과 최댓값을 기준으로 하기 때문에 하나의 극단적인 이상치만 있어도 나머지 값들이 0~1 범위의 매우 좁은 구간에 몰릴 수 있다.
표준화를 사용하는 경우
- 이상치가 있는 경우
정규화와 달리 표준화는 극단적인 값에 의해 왜곡되지 않는다.
결론
정규화와 표준화는 모두 같은 문제를 해결하지만, 그 방법은 서로 다르다. 어떤 방법을 사용해야 할지 확신이 없다면 일반적으로 표준화가 더 안전한 선택이다.
가장 좋은 방법은 자신의 데이터를 이해하고, 이상치가 존재하는지 또는 발생할 가능성이 있는지를 파악한 다음 적절한 방법을 선택하는 것이다. 그래도 확신이 없다면 두 방법 모두 구현하기가 간단하므로 각각 적용해보고 자신의 상황에서 어떤 방법이 더 잘 작동하는지 확인할 수 있다.
특성 스케일링은 쉽게 간과하기 쉬운 단계이지만 모델 성능에는 의외로 큰 영향을 미칠 수 있다. 이를 올바르게 적용하는 작은 습관이 숙련된 데이터 과학자와 경험이 부족한 데이터 과학자를 구분하는 차이가 된다.
면책 조항: 이 글에 제시된 모든 의견은 저자 개인의 의견이다. 저자는 이 글에서 언급한 어떠한 회사나 제품과도 관련이 없다. 별도의 설명이 없는 한 이 글에 포함된 모든 이미지의 저작권은 저자에게 있다.
<출처: https://medium.com/data-science-collective/what-is-normalisation-and-standardisation-eba296eab858>
'통계의 기초' 카테고리의 다른 글
| 마이클 조던이 우연히 설명해 주는 왜도(Skewness) (0) | 2026.09.07 |
|---|---|
| 가설 검정 완벽 이해하기: p-값, 오류, 검정력을 위한 초보자 가이드 (0) | 2026.09.03 |
| 상관관계에서 인과관계로 (0) | 2026.06.20 |
| 중심극한정리가 데이터 과학을 가능하게 하는 방법 (0) | 2026.05.31 |
| 왜 로그가 주식 수익률에 사용되는가? (0) | 2026.05.31 |


댓글